引言
AI 漫劇可以忍受粗糙背景,卻很難忍受讓人分不清角色的聲音。場景裡有三個人,但沒人把聲音綁到對應的角色資產上,於是兩個角色說話是同一種語氣;女主沒有建成一個持續複用的角色資產,臉和年齡感在鏡頭之間跟著變;也沒人說得清哪條配音才是稽核透過的那條。即使畫面還不錯,剪輯也會像後期硬拼起來的。
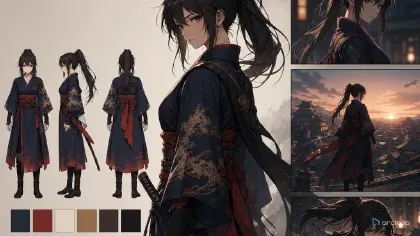
多角色文字轉語音需要在最終影片前先做劇本優先的計畫。打開 創作世界,用 AI 短劇指南 把對白和鏡頭卡綁在一起,再透過 人物三視圖 連接常駐角色,讓同一張臉承載同一套聲音邏輯。
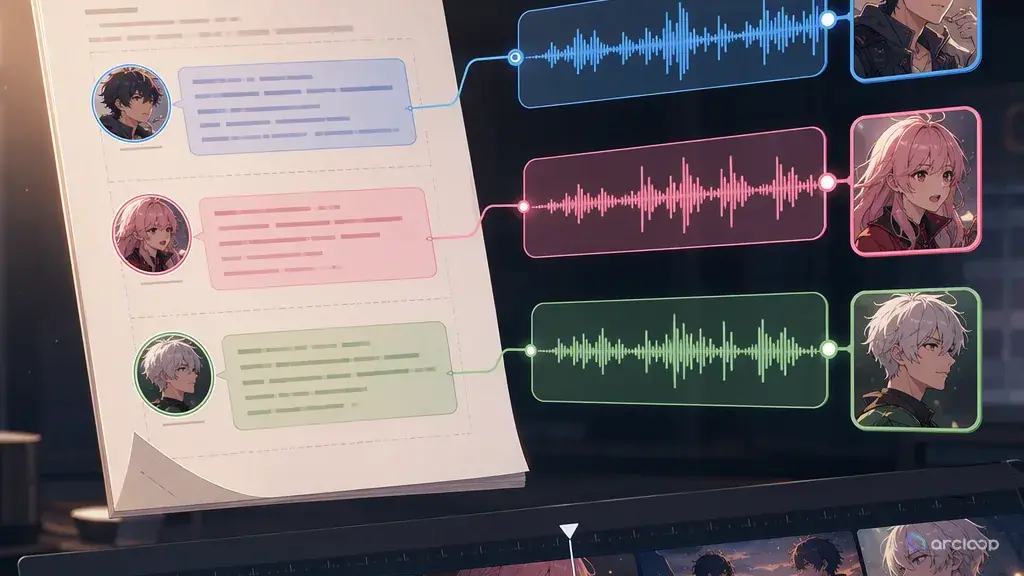
每個角色都要有一條聲音軌道:說話人 ID、年齡感、聲線質感、語速、情緒範圍、發音備註和連續性警示。然後分鏡表再決定哪些台詞需要對口型,哪些台詞放在反應鏡頭上,哪些地方該用沉默穩住節拍。
為什麼聲音需要自己的軌道
聲音不是音訊裝飾。它告訴觀眾誰掌控局面,誰在說謊,誰在藏痛,誰發生了變化。AI 漫劇節奏快,聲音承擔的上下文有時比解釋性台詞更多。
聲音軌道能穩住表演。它定義角色在中性、憤怒、害怕、開玩笑、低聲耳語或崩潰時聽起來是什麼樣。它也定義哪些不該變:年齡感、口音選擇、說話速度、氣息感、音高範圍和情緒天花板。
聲音軌道也能避免說話人混亂。如果劇本裡三位女性角色同處一室,生成前就需要說話人 ID 和清楚不同的表演備註。「女聲 1」和「女聲 2」不夠用。每條聲音都應該匹配角色的身分、地位和情緒功能。
對白位置同樣重要。有些台詞應該讓角色出鏡說。有些放在聽者的反應鏡頭上更有力。有些應該在角色進場前從畫外先響起。如果影片做完後才補 TTS,剪輯裡可能沒有足夠的靜默或正臉時間承接表演。
劇本優先的 TTS 流程
先從劇本中提取所有對白。保留說話人名字、括號裡的表演提示、停頓、打斷和情緒上下文。不要把台詞壓平成人聲旁白。
為常駐角色建立聲音軌道。每條軌道寫清楚說話人 ID、基礎聲線、語速、情緒範圍、壓力下的反應、發音備註和禁止跑偏。把聲音軌道和視覺角色資產庫裡使用的同一個角色 ID 綁起來。
標註台詞位置。決定每句台詞是出鏡、畫外、旁白、電話音、回憶音,還是壓在反應鏡頭下。這會影響鏡頭長度和機位。
最終影片前先生成草稿聲音。粗配音能提前暴露這場戲需要更長停頓、更少台詞或不同的分鏡順序。在精修算圖前修時間,比之後補救便宜。
跨場景審核聲音。聽連續性。女主到第三場聽起來還是同一個人嗎?反派的公開聲線和私下聲線是有意區分的嗎?情緒峰值有沒有落在正確時刻?
最終成片前先通過聲音審核。最終影片應該服務已經確認的表演,而不是強行讓聲音去貼隨機剪出來的片段長度。
讓聲音匹配鏡頭覆蓋
同一句台詞會因為功能不同,需要不同的影片覆蓋。告白可能要落在說話人的臉上,因為嘴、眼神和呼吸都重要。謊言可能更適合壓在聽者反應上,因為觀眾需要看到懷疑形成。威脅台詞可以先從畫外響起,讓入場更有重量。
這些都要在 TTS 定稿前規劃。如果台詞出鏡,鏡頭就需要足夠穩定的正臉時間和適合對口型的構圖。如果台詞在畫外,鏡頭可以專注手部、道具或反應。如果台詞來自電話,聲音軌道可以加入壓縮或距離備註,但不要改變說話人的身分。聲音規劃本質上也是機位規劃。
所以多角色 TTS 應該放在製作流程裡,而不是最後補上去。聲音會告訴剪輯哪裡該呼吸。
範例 1:聲音軌道規格
為這集 AI 漫劇建立多角色 TTS 聲音軌道。

角色:
MAYA,27 歲,外送員,高壓下保持克制,隱藏悲傷。
LEO,30 歲,丈夫,防禦時仍顯得溫和,迴避直接回答。
AVA,26 歲,妹妹,公開場合語氣明亮,私下憤怒尖銳。

請為每個角色輸出:
- 說話人 ID
- 基礎聲線描述
- 語速和停頓規則
- 情緒範圍
- 台詞表演風險
- 發音備註
- 禁止跑偏
- 一句中性台詞和一句情緒台詞的表演示例

規則:
除非劇本明確要求偽裝、電話失真或回憶音訊,否則每條聲音軌道都要跨場景保持穩定。
這會在剪輯這一集之前先建立聲音連續性。
範例 2:對白時間計畫
場景:電梯對峙

台詞計畫:
LEO,畫外,低聲防禦性語速:
"你不該看到那個。"
位置:從 Maya 手握合約的特寫開始。暫時不要露出 Leo。

MAYA,出鏡,安靜克制的聲音:
"這是你今晚說的第一句實話。"
位置:緊特寫,在「實話」前停頓 0.4 秒。

AVA,電話擴音,明亮語氣轉冷:
"Maya,你現在和他在一起嗎?"
位置:電話音壓在 Maya 的反應鏡頭下。輕微壓縮,提示聲音來自電話。

剪輯規則:
Ava 的台詞結束後留 0.7 秒靜默,再打開電梯門。
這個計畫把聲音、機位和剪輯節奏綁在一起。
範例 3:聲音連續性審核
審核這版多角色 TTS 草稿的連續性。

場景:
S01 公寓發現
S02 電梯對峙
S03 天台決定

檢查:
1. MAYA 在所有場景裡都保持同一條低沉、克制的聲音。
2. MAYA 的情緒崩口只出現在 S03,不出現在 S01。
3. LEO 在 S02 的防禦性語速變快,但年齡和音高身分不變。
4. AVA 的電話聲在壓縮後仍然能被認出。
5. 反應鏡頭之間沒有說話人軌道互換。
6. 停頓給計畫中的特寫留出足夠空間。
這類審核能在最終合成前抓住聲音跑偏。
常見踩坑
最大的坑,是剪輯鎖死後才生成聲音。對白時間應該塑造剪輯,而不是和剪輯硬撞。
另一個坑,是給相似角色使用相似聲音。一個演員陣容需要在語速、質感、節奏和情緒反應上有對比。
創作者也常忘記畫外台詞。畫外聲音可以製造張力,但它仍然必須綁定說話人 ID。
最後,不要每句都演到爆。AI 漫劇需要峰值,也需要克制。如果每句都像高潮,真正的高潮就沒地方上去了。
FAQ
AI 漫劇需要多少條聲音軌道?
每個常駐說話角色一條。如果劇本需要旁白、電話音、回憶音或偽裝聲,也要單獨建軌道。
應該在影片前還是影片後生成聲音?
最終影片前先生成草稿聲音。它能幫助確定鏡頭長度、反應節奏、停頓和剪輯點。
怎麼讓跨集聲音保持一致?
重複使用說話人 ID、聲線描述、語速規則、發音備註和情緒上限。最終混音前,把新台詞和已審核聲音軌道逐條對照。