很多人第一次使用豆包音频生成模型 1.0,会把它当成普通文字转语音:输入一句台词,期待模型自动补出情绪。这样能得到清楚的人声,但很难得到一段“像戏”的音频。 这份指南的核心结论很简单:豆包音频生成模型 1.0 更适合用导演式 Prompt 驱动。不要只写台词,要把角色、说话方式、音效、环境和配乐放在同一条时间线里。模型理解的是一段音频场景,而不是孤立的一句朗读。
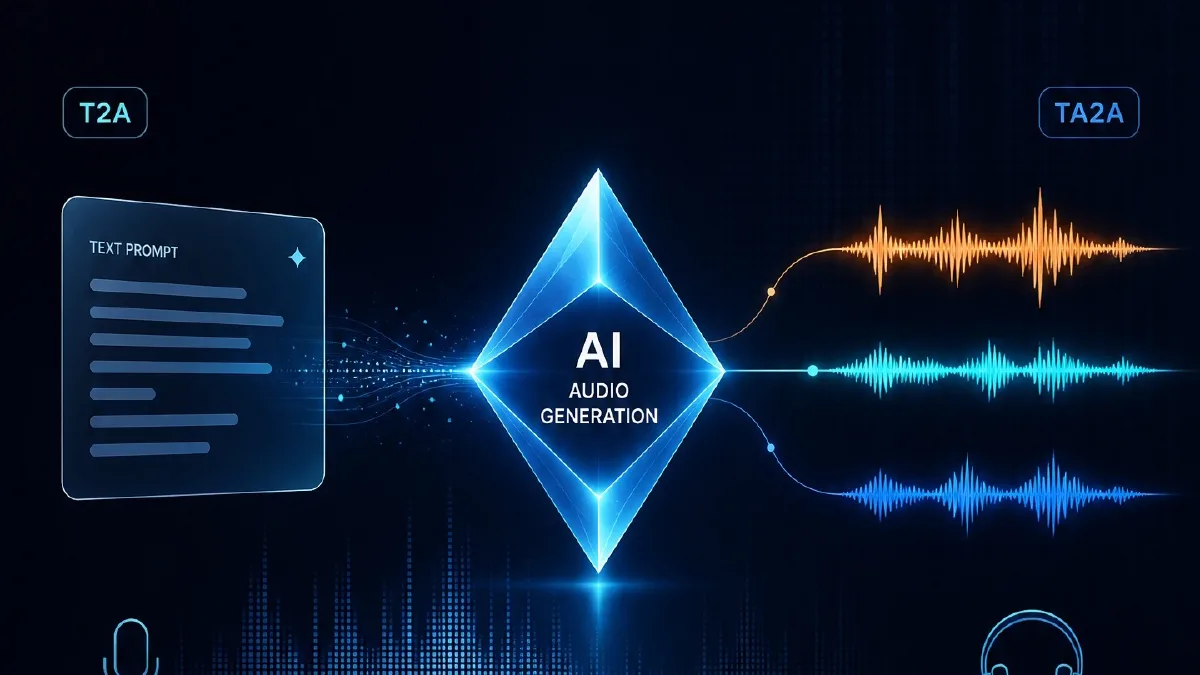
先分清 T2A 和 TA2A
T2A(文本/图片生音频)适合从零生成:角色配音、旁白、短剧片段、虚拟主播、有声书片段,都可以直接用自然语言描述。图片可以辅助角色外观和气质,但单次只能用一张图片,且不能和参考音频同时使用。
TA2A(参考音频生音频)适合保持音色:上传 1 到 3 条参考音频,或引用音色库/复刻音色,再在 Prompt 里用 @音频1、@音频2、@音色1 指定谁使用哪个参考。它适合品牌 IP、固定角色、虚拟代言人和多角色对白。
- 没有固定音色时,先用 T2A 找表演方向。
- 需要角色跨集不换人时,用 TA2A 把参考音频和角色绑定。
- 多人对话不要只上传素材,要在 Prompt 中明确每个角色对应哪个
@音频N。
Prompt 的主结构:按时间顺序写一段声音脚本
最稳的写法不是“情绪词 + 台词”,而是按音频发生顺序写:音乐如何开始,角色 A 怎么出现,角色 A 说什么,中间穿插什么音效,角色 B 如何回应。 可以把 Prompt 看成声音分镜。每一段都回答三个问题:谁在说、怎么说、现场还有什么声音。
音乐/环境先出现:写清风格、乐器、节奏或空间氛围。
人物A(年龄、性别、声线、口音、情绪、角色属性)用某种方式说:“台词”。
音效:按时间顺序写出现什么声音、轻重、数量或持续时间。
人物B(音色和说话方式)回应:“台词”。
结尾:音乐、脚步、门声、电话失真或环境声如何收束。
角色对白怎么写
角色提示最好放在第一次说话前,或角色列表里。多说话人场景必须用姓名、身份或编号区分,不要只写“男声”“女声”。 括号里的角色描述可以包含年龄、性别、声线、口音、情绪、职业属性、距离感和说话习惯。描述越接近“能听见的行为”,越容易控制。
- 可写:低沉、沙哑、气声、磁性、电话失真、台湾口音、语速偏慢、句尾发颤。
- 慎写:高级、破碎、宿命、电影感。抽象词要落成具体声音行为。
- 情绪不要过度堆叠。过强的情绪词反而可能降低自然度。
音效和配乐不要当成附属信息
豆包音频生成模型 1.0 的优势之一,是能把对白、音效和音乐放进同一段音频里。音效可以用自然语言写,不需要专业音效库术语。 音效推荐写时间顺序、强度、数量和持续时间。配乐推荐写音乐风格、主奏乐器、节奏和氛围。如果不知道乐器名,也可以用“轻柔舒缓的钢琴曲”“紧张悬疑的低频铺底”这样的自然描述。
先是一声手机震动,环境中有持续的鸟鸣。
音乐以马林巴和弦乐铺底,节奏紧张悬疑。
随后出现一阵轻微汽车行驶声,接着一声刹车,再出现两声高跟鞋脚步声。
TA2A 参考音频怎么写
参考音频不是“上传就自动懂”。Prompt 里仍然要指定参考对象,并说明它提供的是音色、情绪、语速,还是某个角色的说话方式。 多参考时,最常见的两种用法是:每个参考音频绑定一个角色;或一个参考音频给音色,另一个参考音频给情绪和节奏。
男主(中青年男性,低沉、克制,参考 @音频1)压低声音说:“你是什么时候发现的?”
女主(青年女性,温柔但防备,参考 @音频2)停顿半拍后回答:“从你第一次说谎开始。”
音乐保持低频悬疑,句尾出现轻微电话电流声。
可直接复制的 T2A 模板
先用这个模板跑一版,再根据试听结果只改一个变量:音色、情绪、节奏或音效。
配乐描述:一段低频、克制的悬疑配乐先进入,节奏缓慢,弦乐轻轻铺底。
角色列表:
林澈(中青年男性,声音低沉、沙哑,语速偏慢,情绪压住,像不愿承认自己害怕)
许遥(青年女性,声音清亮但疲惫,句尾轻微发颤,正在努力保持冷静)

音效:先是一声手机震动,随后有很轻的雨声。
林澈压低声音说:“你刚才听见了吗?楼上有人。”
许遥停顿半拍,吸了一口气,用很轻的声音回答:“别回头,继续往前走。”
音效:远处传来一声木门缓慢打开的声音,配乐里的低音加重。
可直接复制的 TA2A 模板
当你已经有角色参考音频时,用这个模板把音色绑定到角色上。
参考说明:@音频1 是男主音色,@音频2 是女主音色。
音乐:轻微钢琴和环境铺底,整体温柔但带一点遗憾。
男主(成年男性,低沉、气声偏多,参考 @音频1)用克制又不舍的语气说:“如果明天我没有回来,你就别等了。”
女主(青年女性,温柔、带哭腔,参考 @音频2)轻声打断他:“我等不等,不是你说了算。”
音效:窗外有细雨声,最后一句后保留两秒安静。
限制会直接影响 Prompt 长度
单次音频最长约 2 分钟。输入文本不超过 3000 字符,但为了听感,单次播报字数建议控制在 400 字以内。台词太长时,模型可能加快语速或截断。 参考音频最多 3 条,每条不超过 30 秒。参考图片单次 1 张,且不能和参考音频同用。
- 短剧对白:一场戏拆成 30 到 90 秒更容易控制。
- 长有声书:按情绪段落拆,不要把一整章塞进一次生成。
- 多角色场景:先锁定每个角色的音色,再扩展音效和配乐。
放进 Arcloop 工作流时怎么用
- 先在角色手册里写清角色声线:年龄、声线、口音、说话方式和情绪边界。
- 把剧本拆成可生成片段:一段只处理一个主要情绪转折。
- 为每段选择 T2A 或 TA2A:探索用 T2A,固定角色用 TA2A。
- 试听后把有效 Prompt 回写成角色资产,失败 Prompt 也保留原因。
- 再把音频放回分镜和视频片段里检查,不要只单独听声音。
FAQ
豆包音频生成模型 1.0 和普通 TTS 最大差别是什么?
普通 TTS 更像读一句话;豆包音频生成模型 1.0 更像生成一段音频场景,可以同时描述对白、环境声、音效和音乐。
Prompt 越长越好吗?
不是。Prompt 要具体,但不要把所有形容词堆上去。先写清角色、台词、音效和配乐的时间顺序,再根据试听补细节。
多角色对白怎样保持音色一致?
用 TA2A,为每个角色绑定 @音频N,并在每次角色说话时标清 speaker 和参考对象。
括号里的动作会不会被念出来?
有风险。关键动作可以改成“语气/状态”写在角色描述里,或用明确的提示格式和台词正文分开。生成后要听一遍确认。