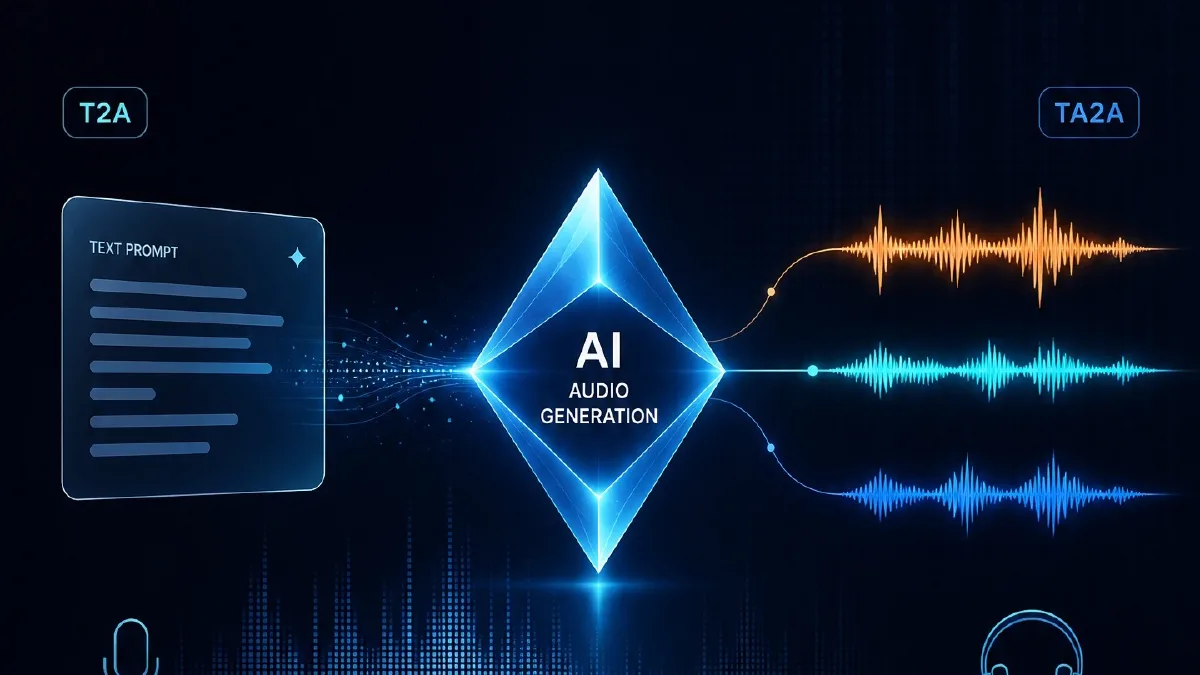
豆包音声生成モデル 1.0 を最初に使うとき、多くの人は普通の TTS のように一行の台詞を入れ、演技を自動で補ってくれることを期待します。それでも明瞭な音声は出ますが、「シーン」にはなりにくいです。 実践上の要点は単純です。豆包 Audio 1.0 はディレクター式 Prompt と相性がよい。台詞だけでなく、人物、話し方、環境音、効果音、音楽を同じ時間軸に置きます。
まず T2A と TA2A を分ける
T2A(テキスト/画像から音声)はゼロから作る用途です。キャラクターボイス、ナレーション、短いドラマ、有声書、バーチャル司会に向きます。参照画像は人物の雰囲気を助けますが、一回に使える画像は一枚で、参照音声とは併用できません。
TA2A(参照音声 + テキストから音声)は声を保つ用途です。1 から 3 本の参照音声、または音色ライブラリ/複製音色を使い、Prompt 内で @音声1、@音声2、@音色1 のように指定します。
- 演技の方向を探る段階では T2A を使う。
- 連載キャラクターの声を固定したいときは TA2A を使う。
- 複数話者では、各人物と参照音声の対応を Prompt 内に明記する。
基本構造:時間順に音の脚本を書く
安定する書き方は「感情 + 台詞」ではありません。音楽がどう始まり、誰が入り、どう話し、どの効果音が挟まり、相手がどう返すかを順番に書きます。 Prompt は音の絵コンテです。各ビートで「誰が話すか」「どう話すか」「ほかに何が聞こえるか」を決めます。
音楽/環境音:スタイル、楽器、リズム、空間を説明する。
人物A(年齢、性別、声質、アクセント、感情、役割)が「台詞」を言う。
効果音:何が、どの強さで、何回、どのくらい続くかを書く。
人物Bが自分の声質と話し方で返す。
終わり:音楽、足音、ドア、電話の歪み、環境音をどう収束させるか。
キャラクター会話の書き方
人物指示は最初の台詞の前、または短い人物リストに置きます。複数話者では名前、役割、番号で区別します。「男声」「女声」だけでは足りません。 括弧内の説明には、年齢、性別、声質、アクセント、感情、役割、距離感、話し癖を書けます。抽象的な雰囲気より、聞こえる行動のほうが効きます。
- 使いやすい表現:低い、かすれ、息多め、電話越し、台湾アクセント、遅め、語尾が震える。
- 単独では弱い表現:高級感、壊れそう、映画的、宿命的。具体的な音の行動に直す。
- 感情を積みすぎない。過剰な感情指定は自然さを落とします。
効果音と音楽も Prompt の一部
豆包 Audio 1.0 の強みは、会話、効果音、環境音、音楽を一緒に生成できることです。効果音は専門用語ではなく、自然な説明で書けます。 効果音は順番、強さ、回数、持続時間を書く。音楽はスタイル、主な楽器、リズム、ムードを書く。楽器名が分からない場合は、感覚を自然言語で書いて構いません。
最初にスマートフォンの振動音。背景には鳥の声が続く。
マリンバと弦楽器の緊張感ある音楽が入る。
その後、遠くで車が通り、軽いブレーキ音、二回のハイヒールの足音が聞こえる。
TA2A の参照音声の書き方
参照音声はアップロードするだけでは足りません。Prompt 内で参照名を指定し、それが音色、感情、速度、あるいはキャラクター性のどれを提供するかを書きます。 複数参照では、一人一つの参照を割り当てるか、一つを音色、もう一つを感情とリズムに使います。
男主人公(若い男性、低く抑えた声、@音声1 を参照)が声を落として言う:「いつ気づいた?」
女主人公(若い女性、優しいが警戒している、@音声2 を参照)が半拍置いて答える:「あなたが最初に嘘をついた時から。」
音楽は低くサスペンス調のまま。語尾にかすかな電話ノイズを入れる。
コピーできる T2A テンプレート
まず一度生成し、その後は声、感情、速度、効果音のどれか一つだけを変えます。
音楽:低く抑えたサスペンスの音が先に入る。遅いテンポ、薄い弦の質感。
人物:
林澈(若い男性、低くかすれた声、遅め、感情を抑え、怖いが認めたくない)
許遥(若い女性、澄んでいるが疲れた声、語尾が少し震え、冷静でいようとしている)

効果音:スマートフォンが一度振動し、弱い雨音が続く。
林澈は声を落として言う:「今の、聞こえた? 上に誰かいる。」
許遥は半拍止まり、息を吸って、とても小さく答える:「振り向かないで。そのまま歩いて。」
効果音:遠くで木のドアがゆっくり開く。音楽の低音が重くなる。
コピーできる TA2A テンプレート
キャラクターの参照音声がある場合は、Prompt の中で直接結びます。
参照対応:@音声1 は男主人公。@音声2 は女主人公。
音楽:柔らかいピアノと部屋の空気。温かいが少し後悔がある。
男主人公(成人男性、低く息が多い、@音声1 を参照)が抑えた未練で言う:「明日戻らなかったら、もう待たないで。」
女主人公(若い女性、優しく涙声、@音声2 を参照)が静かに遮る:「待つかどうかは、あなたが決めることじゃない。」
効果音:窓の外に細い雨。最後の台詞の後、二秒の静けさを残す。
制限は Prompt の長さに直結する
一回の生成はおよそ最大 2 分です。入力は 3000 文字以内ですが、聞きやすさのため、朗読本文は短めに保つのが安全です。長すぎる台詞は速度が上がるか、途中で切れることがあります。 参照音声は最大 3 本、各 30 秒以内。参照画像は一回に 1 枚で、参照音声とは併用できません。
- ドラマ会話は 30 から 90 秒単位に分ける。
- 有声書は章ではなく感情のまとまりで分ける。
- 複数キャラクターでは、先に声を固定し、その後に効果音と音楽を加える。
Arcloop のワークフローで使う方法
- キャラクター手帳に声の基準を書く:年齢、声質、アクセント、話し方、感情の境界。
- 脚本を生成しやすいビートに分ける。一つのビートは一つの主な感情変化にする。
- ビートごとに T2A / TA2A を選ぶ。探索は T2A、固定キャラクターは TA2A。
- 試聴後、うまくいった Prompt をキャラクター資産として保存し、失敗例も理由つきで残す。
- 単体音声だけでなく、絵コンテや動画カットの中で確認する。
FAQ
豆包 Audio 1.0 は普通の TTS と何が違いますか?
普通の TTS は声を読みます。豆包 Audio 1.0 は会話、環境音、効果音、音楽を含む音声シーンを生成できます。
Prompt は長いほどよいですか?
いいえ。具体的であることが大切です。まず時間順、話者、台詞、効果音、音楽を書き、試聴後に細部を足します。
複数キャラクターの声を保つには?
TA2A を使い、各人物を @音声N に結び、話すたびに speaker と参照を明記します。
括弧内の動作は読み上げられますか?
可能性があります。重要な動作は話し方の指示に変えるか、台詞本文と明確に分けてください。必ず一度確認します。