Penjana audio AI Seed Audio 1.0 untuk drama pendek dan animasi
Jana sehingga dua minit dialog, bunyi persekitaran, kesan bunyi dan audio adegan dengan satu klik. Arahkan lakonan watak, urutan masa dan suasana melalui satu gesaan.
Mengapa Seed Audio 1.0 sesuai untuk audio adegan
Program
Jana audio adegan lengkap sekali gus
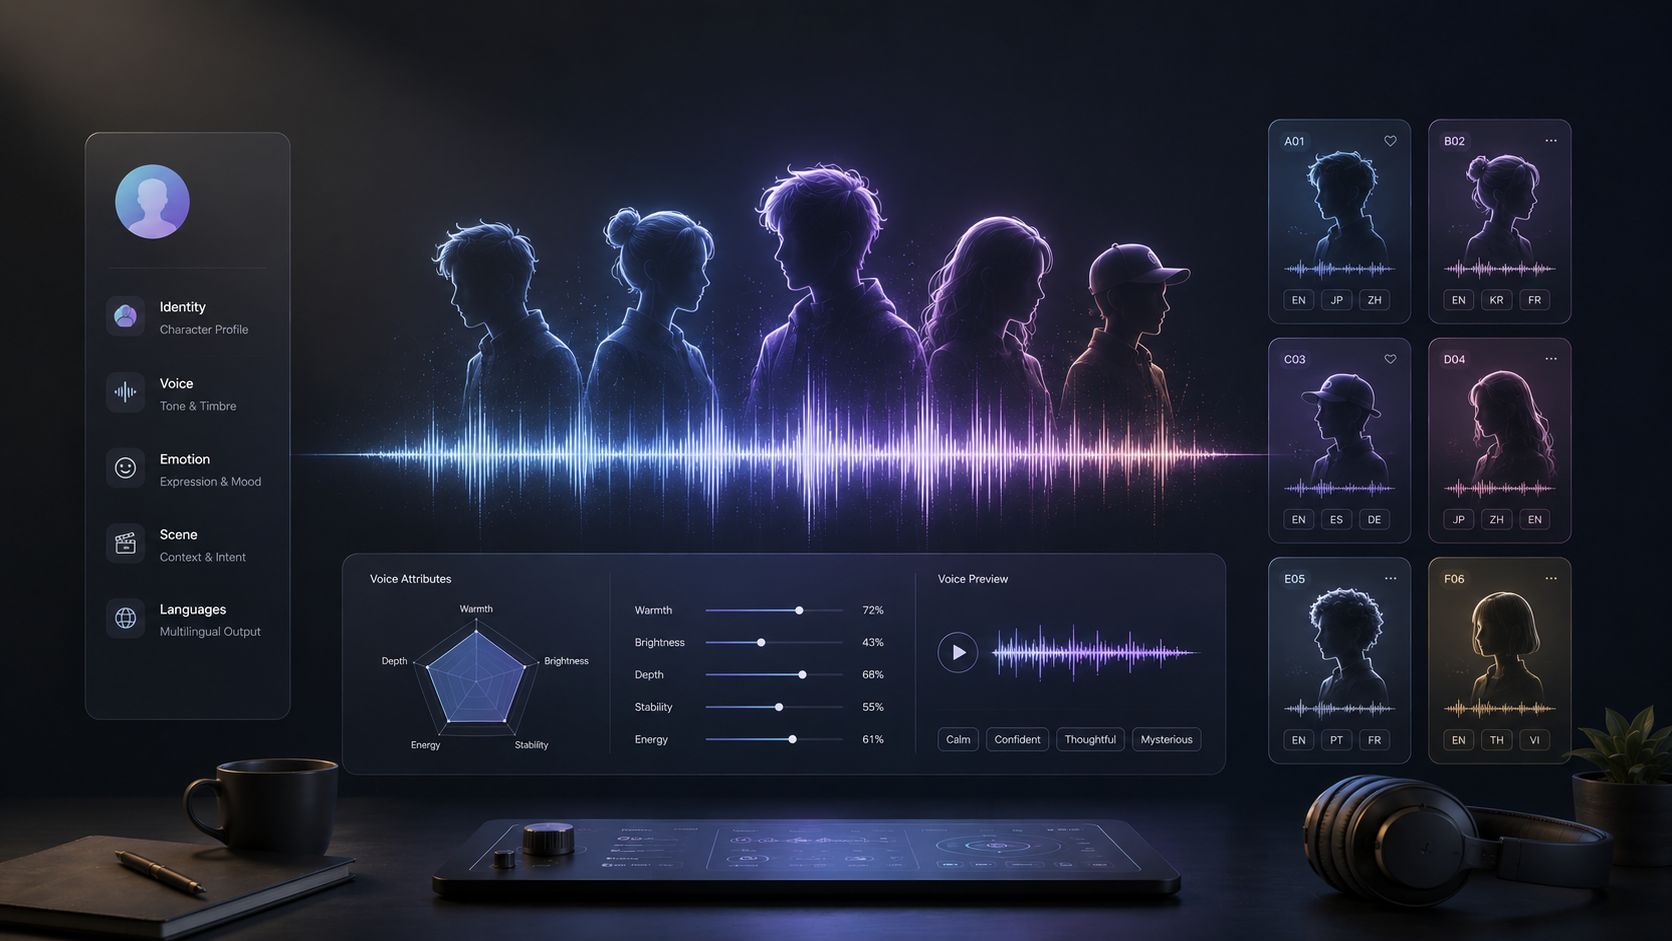
Dialog, bunyi persekitaran, muzik dan kesan bunyi dijana bersama dengan tahap bunyi yang seimbang. Muzik dilaraskan agar suara kekal jelas. Anda mendapat trek audio yang siap diadun, tanpa perlu melaraskan empat trek berasingan.
Kawal urutan bunyi dalam adegan
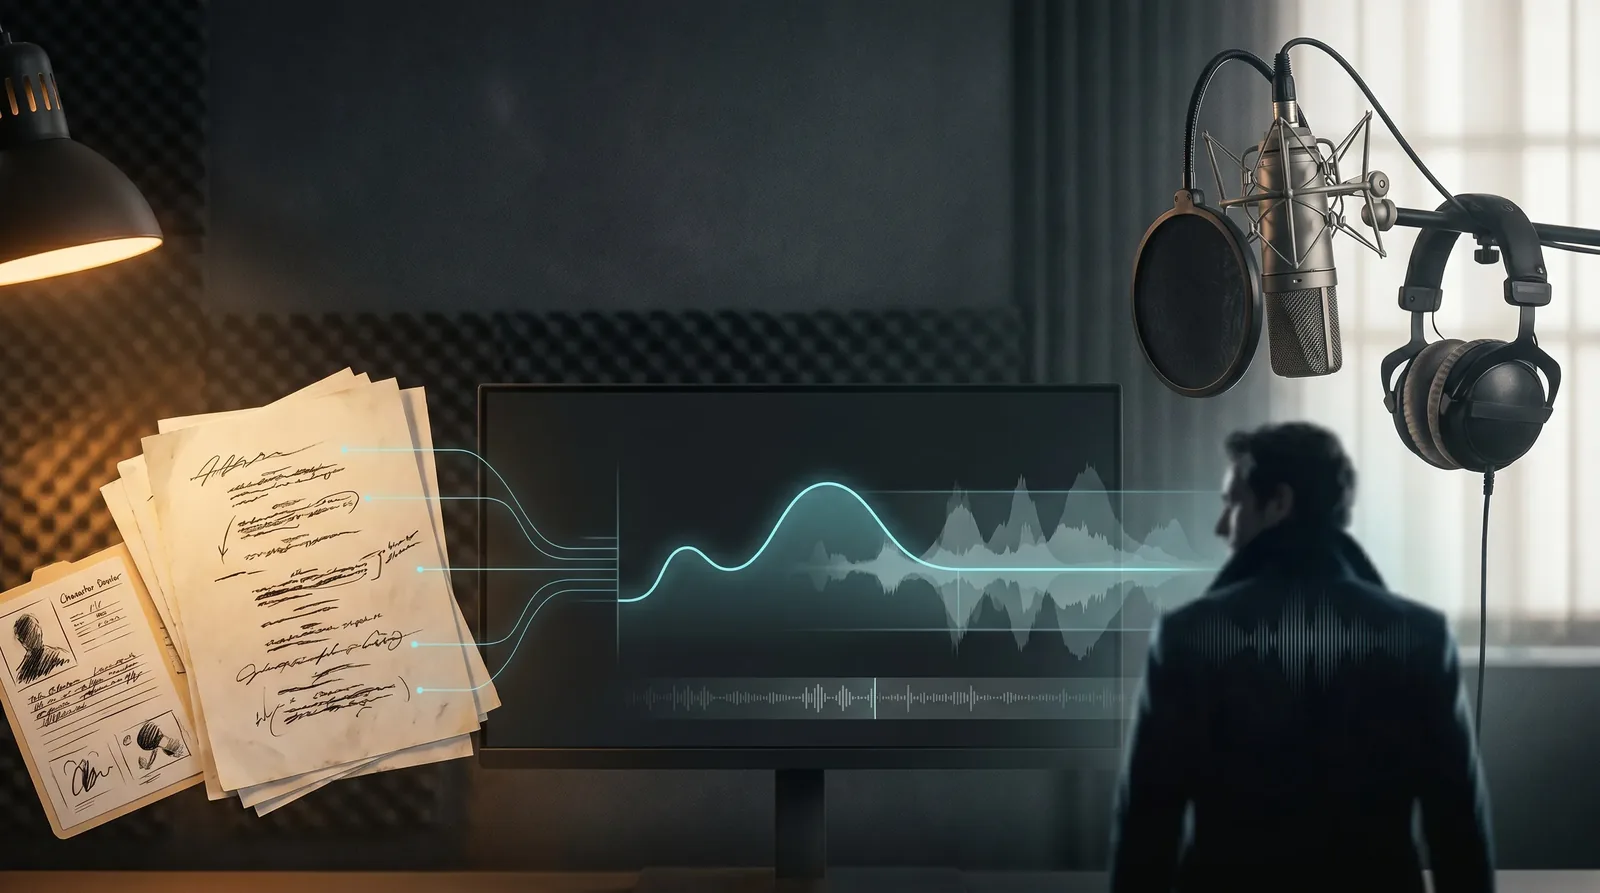
Tulis adegan mengikut urutan cerita dan audio akan mengikut urutan itu, dengan ketepatan masa hingga 100 milisaat. Dialog ketiga muncul di tempat ketiga, dan bunyi pintu yang ditulis antara dua dialog muncul di antaranya. Ini membolehkan anda menyusun visual mengikut audio.
Jana sehingga 2 minit audio
Cukup panjang untuk satu adegan atau narasi lengkap, dengan suara yang sama dari perkataan pertama hingga terakhir. Sambung penjanaan dari tempat anda berhenti jika adegan lebih panjang.
Cipta audio watak dalam lebih 20 bahasa
Sokongan termasuk bahasa Cina, Inggeris, Jepun, Korea, Sepanyol, Jerman, Perancis, Thai, Vietnam dan banyak lagi. Terbitkan siri dalam beberapa bahasa tanpa mencari pelakon suara baharu.
Cara menggunakan Seed Audio 1.0 dalam Arcloop
Follow the key steps to guide, generate, and refine with Seed Audio 1.0.
Pilih Suara
Pilih suara watak atau tambah audio rujukan yang anda berhak gunakan, sesuai dengan adegan anda.
01
Tulis adegan anda
Masukkan dialog dan terangkan emosi, rentak, masa, bunyi persekitaran serta kesan bunyi yang ingin didengar.
02
Jana audio anda
Jana audio adegan, dengar hasilnya dan perhalus gesaan sehingga suara serta suasana menepati visi anda.
03
Cara menulis gesaan Seed Audio 1.0
Nyatakan siapa yang bercakap, ciri suaranya dan perkara yang berlaku antara dialog. Terangkan watak ketika kemunculan pertamanya, kemudian tulis mengikut urutan adegan dimainkan.
Nyatakan umur, ciri suara dan kelajuan pertuturan dalam kurungan. Selepas itu, cukup tulis "Nama berkata:" untuk mengekalkan suara yang sama.
Susun peristiwa antara dialog mengikut urutan. Model tidak menganggap frasa "pada masa yang sama" sebagai bunyi bertindih. Jika kesan bunyi perlu berlaku di tengah dialog, pecahkan dialog kepada dua bahagian dan letakkan kesan bunyi di antaranya.
Tulis "Runut bunyi:" diikuti penerangan muzik dan tempohnya. Penerangan suasana sahaja sering menghasilkan kesan bunyi dua saat, bukannya muzik latar.
Penerangan teks sudah boleh menentukan suara. Jika suara watak perlu kekal sama antara episod, muat naik sehingga tiga klip rujukan berdurasi 30 saat setiap satu dan gunakan semula rujukan itu apabila watak bercakap.
Petua dan panduan daripada pakar
Baca panduan praktikal tentang reka bentuk suara, penulisan gesaan dan penghasilan audio dalam ArcLoop.
Seed Audio 1.0 ialah model penjanaan audio AI daripada pasukan Seed ByteDance. Ia menjana dialog, suara watak, bunyi persekitaran, kesan bunyi dan audio adegan daripada teks serta audio rujukan. Ia sesuai untuk drama pendek, animasi dan kandungan naratif.
2. Apakah perbezaan antara Seed Audio 1.0 dengan teks kepada pertuturan?
Teks kepada pertuturan biasanya menukar tulisan menjadi suara. Seed Audio 1.0 boleh menjana adegan audio lengkap dengan beberapa watak, emosi, rentak, bunyi persekitaran dan kesan bunyi berdasarkan konteks yang sama.
3. Berapa lamakah audio yang boleh dijana oleh Seed Audio 1.0?
Seed Audio 1.0 boleh menjana audio sehingga dua minit. Ia sesuai untuk dialog panjang, narasi, jujukan animasi dan episod drama pendek tanpa perlu menjana setiap baris dialog secara berasingan.
4. Apakah perbezaan antara T2A dan A2A?
T2A menukar gesaan teks menjadi audio baharu, termasuk suara, dialog, bunyi persekitaran dan kesan bunyi. A2A menggunakan audio sedia ada sebagai rujukan untuk menjana audio baharu berdasarkan ciri suara atau akustiknya.
5. Bahasa mana yang disokong oleh Seed Audio 1.0?
Seed Audio 1.0 menyokong lebih daripada 20 bahasa, termasuk bahasa Inggeris, Cina, Jepun, Korea, Perancis, Jerman, Sepanyol dan Thai. Ini menjadikannya berguna untuk watak berbilang bahasa, animasi setempat dan penghasilan drama antarabangsa.
6. Mengapa gesaan yang sama menghasilkan audio yang berbeza?
Gesaan yang sama boleh menghasilkan lakonan, rentak, suara atau butiran bunyi yang berbeza. Untuk hasil lebih konsisten, terangkan watak, emosi, urutan masa, persekitaran dan arahan bunyi dengan jelas.
7. Seed Audio 1.0 atau ElevenLabs: Mana lebih sesuai untuk projek saya?
Pilih Seed Audio 1.0 jika dialog, lakonan watak, bunyi persekitaran dan kesan bunyi perlu menjadi satu adegan lengkap. ElevenLabs sering lebih sesuai jika keutamaan anda ialah penjanaan suara, narasi atau pengklonan suara. Pilih mengikut keperluan anda: audio satu adegan penuh atau pertuturan sahaja.
Teroka lebih banyak model AI
Explore other models for the next step in your creative workflow.
Seedance 2.0
Seedance 2.5
Nano Banana Pro
Kling Omni
GPT Image 2
Seedream 5.0
Grok Imagine
Seed Audio 1.0
ElevenLabs
Seedance 2.0
Seedance 2.5
Nano Banana Pro
Kling Omni
GPT Image 2
Seedream 5.0
Grok Imagine
Seed Audio 1.0
ElevenLabs
Bermula dengan satu adegan
Terangkan watak dan tulis dialog untuk menjana audio lengkap dengan suara, bunyi persekitaran serta muzik.