Seed Audio 1.0: generatore di audio IA per miniserie e animazioni
Genera fino a due minuti di dialoghi, suoni ambientali ed effetti in un clic. Dirigi interpretazioni, tempi e atmosfera con un unico prompt.
Perché usare Seed Audio 1.0 per l’audio delle scene
Learn how Seed Audio 1.0 turns your ideas and references into creative results.
Genera una scena audio completa in un solo passaggio
Dialoghi, suoni ambientali, colonna sonora ed effetti vengono generati insieme e già bilanciati. La musica si abbassa automaticamente durante le battute. Il risultato è una traccia finita, senza dover regolare quattro tracce separate.
Mantieni l’ordine narrativo della scena
Scrivi gli eventi in ordine narrativo: l’audio seguirà la stessa sequenza, con una precisione di 100 millisecondi. La terza battuta arriva per terza e una porta si apre tra le battute indicate. Così l’audio può guidare il montaggio.
Genera fino a 2 minuti di audio
Hai spazio per una scena o una narrazione completa, con la stessa voce dalla prima all’ultima parola. Se la scena dura di più, continua dal punto in cui si è interrotta.
Dai voce ai personaggi in oltre 20 lingue
Cinese, inglese, giapponese, coreano, spagnolo, tedesco, francese, tailandese, vietnamita e altre lingue: puoi realizzare una serie multilingue mantenendo le voci dei personaggi.
Come usare Seed Audio 1.0 su Arcloop
Follow the key steps to guide, generate, and refine with Seed Audio 1.0.
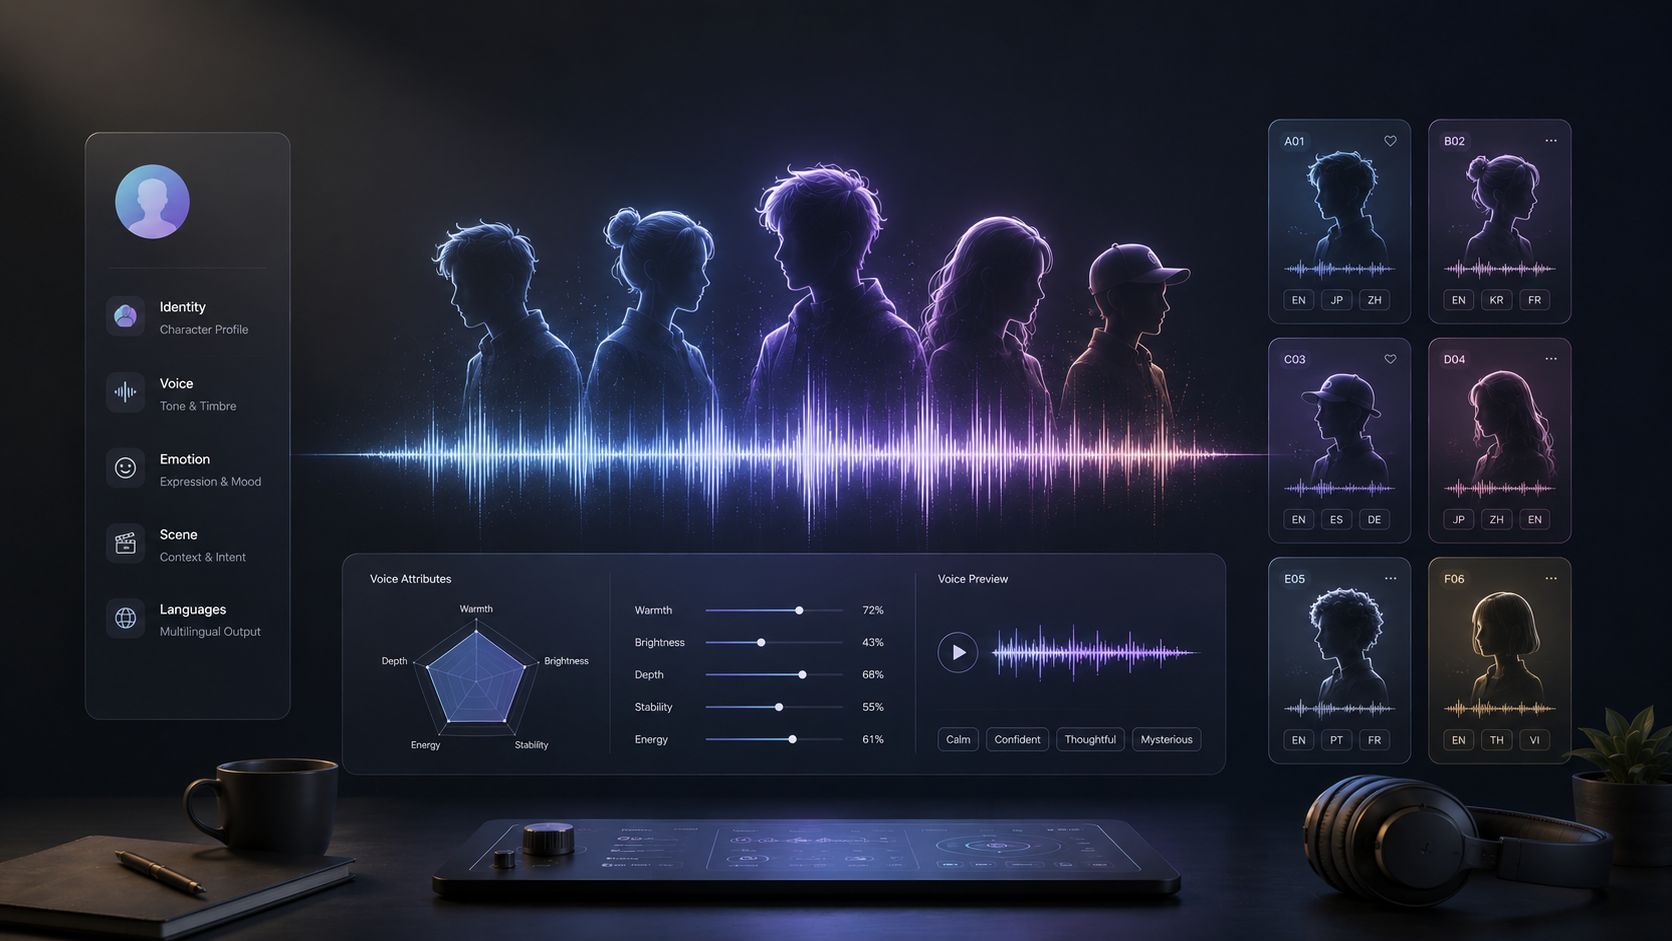
Scegli una voce
Scegli una voce di personaggio o aggiungi un riferimento vocale autorizzato che si adatta alla tua scena.
01
Scrivi la tua scena
Inserisci i dialoghi e descrivi emozioni, ritmo, tempi, ambiente ed effetti sonori desiderati.
02
Genera il tuo audio
Genera la scena, visualizza l'anteprima del risultato e affina il prompt fino a quando le voci e il suono corrispondono al momento che vuoi creare.
03
Come scrivere un prompt per Seed Audio 1.0
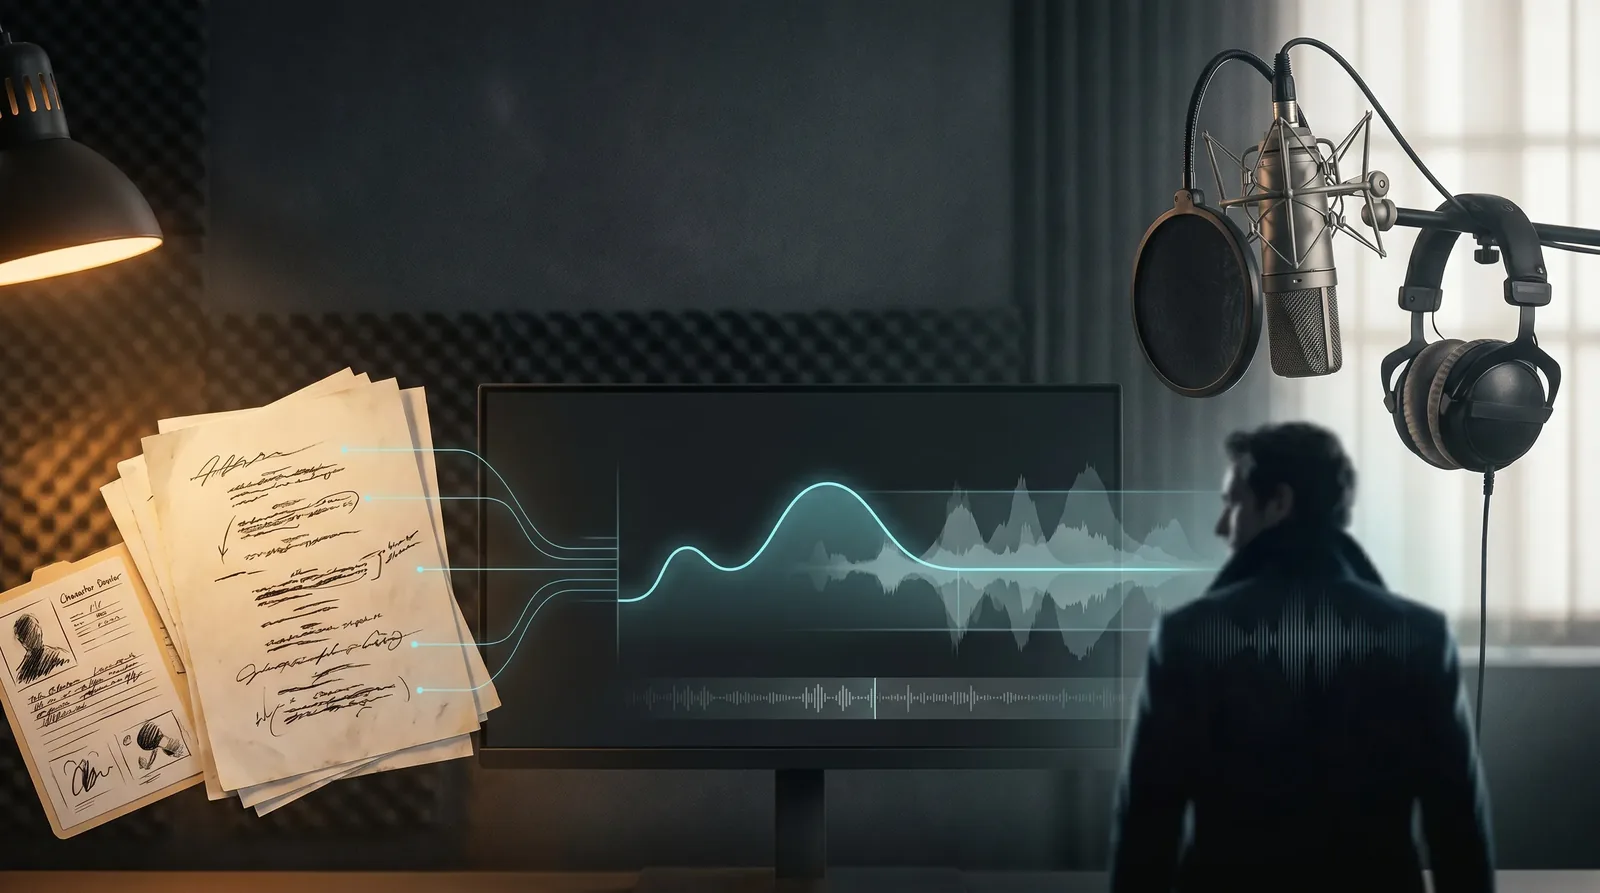
Seed Audio interpreta il prompt come una pagina di sceneggiatura: chi parla, come suona la voce e cosa accade tra le battute. Presenta ciascun personaggio una volta, poi descrivi gli eventi nell’ordine in cui devono essere ascoltati.
Indica tra parentesi età, timbro e ritmo. Dalle battute successive basta scrivere «nome dice:»: la voce mantiene le caratteristiche definite.
Descrivi gli eventi tra le battute nell’ordine desiderato. Scrivere «nel frattempo» non basta a far sovrapporre i suoni: se un effetto deve interrompere una battuta, dividila in due e inserisci l’effetto al centro.
Scrivi «Soundtrack:» e descrivi la musica e la durata desiderata. Una semplice indicazione d’atmosfera può produrre un effetto di due secondi anziché una colonna sonora.
Una descrizione testuale definisce la voce da zero. Per mantenerla coerente tra gli episodi, carica fino a tre clip di 30 secondi ciascuna e riutilizza il riferimento a ogni battuta.
Consigli e approfondimenti degli esperti
Scopri guide pratiche su progettazione delle voci, prompt e produzione audio con ArcLoop.
Seed Audio 1.0 è un modello di generazione audio IA di ByteDance Seed. Crea dialoghi, voci dei personaggi, suoni ambientali ed effetti a partire da testo e riferimenti audio, per miniserie, animazioni e contenuti narrativi.
2. In cosa si differenzia dalla sintesi vocale?
La sintesi vocale tradizionale converte un testo in parlato. Seed Audio 1.0 può generare l’audio di un’intera scena con più personaggi, emozioni, ritmo, ambiente ed effetti sonori nello stesso contesto.
3. Quanto può durare l’audio generato?
Seed Audio 1.0 può generare audio fino a due minuti. Questo lo rende utile per scene di dialogo più lunghe, narrazioni, sequenze di animazione e brevi episodi di dramma senza dividere ogni linea in clip separati.
4. Qual è la differenza tra T2A e A2A?
T2A trasforma un prompt di testo in nuovo audio, tra cui voci, dialogo, ambiente ed effetti sonori. A2A utilizza l'audio esistente come riferimento e genera nuovi audio in base alle sue caratteristiche vocali o acustiche.
5. Quali lingue supporta Seed Audio 1.0?
Seed Audio 1.0 supporta oltre 20 lingue, tra cui inglese, cinese, giapponese, coreano, francese, tedesco, spagnolo e tailandese. È utile per personaggi multilingue, animazioni localizzate e serie destinate a più paesi.
6. Perché lo stesso prompt può produrre risultati diversi?
La generazione audio IA non è del tutto deterministica: lo stesso prompt può produrre interpretazioni, ritmi, voci e dettagli sonori diversi. Per risultati più coerenti, descrivi chiaramente personaggi, emozioni, tempi, ambiente e suoni.
7. Seed Audio 1.0 vs ElevenLabs: Qual è meglio per il mio progetto?
Seed Audio 1.0 è adatto a scene in cui dialoghi, interpretazione, ambiente ed effetti devono funzionare insieme. ElevenLabs può essere più indicato per la sola generazione di voci, narrazione o clonazione vocale. Scegli in base alla necessità di creare una scena completa oppure principalmente del parlato.
Scopri di più IA Modelli
Explore other models for the next step in your creative workflow.
Seedance 2.0
Seedance 2.5
Nano Banana Pro
Kling Omni
GPT Image 2
Seedream 5.0
Grok Imagine
Seed Audio 1.0
ElevenLabs
Seedance 2.0
Seedance 2.5
Nano Banana Pro
Kling Omni
GPT Image 2
Seedream 5.0
Grok Imagine
Seed Audio 1.0
ElevenLabs
Inizia con una scena
Descrivi i personaggi e scrivi le battute: ottieni dialoghi, suoni ambientali e musica in un’unica traccia.